제품 > ComputeAI™

더 빠르고 예측 가능한 AI 배포를 위한 고성능 컴퓨팅 시스템

통합 복잡성을 줄이고 AI 인프라 설계 위험을 최소화하며, 각 AI 성과에 적합한 기술을 선택할 수 있는 유연성을 유지하십시오.

문의하기
가격 요청
고급 컴퓨팅 포트폴리오

가치 창출 시간을 단축하고 예측 가능한 성능을 보장하는 사전 검증된 컴퓨팅

AI 팩토리를 구축하고 관리하려면 상당한 자본 투자와 운영의 정밀함이 요구됩니다. 기존의 구축 방식은 컴퓨팅 통합 문제나 벤더의 설계 제한으로 인해 지연되는 경우가 많습니다. 인프라가 지연되거나 제대로 활용되지 않으면 투자 수익률이 저하됩니다.

Penguin Solutions ComputeAI™ 포트폴리오는 이러한 복잡성과 위험을 줄여줍니다. 일관된 성능을 지원하도록 설계된 프로덕션 준비 완료 상태의 사전 검증된 고급 컴퓨팅 시스템을 통해, 조직은 하드웨어 통합에 소요되는 시간을 줄이고 AI 이니셔티브를 발전시키며 비즈니스 가치를 창출하는 데 더 많은 시간을 할애할 수 있습니다.

25년 이상의 AI 및 HPC 경험을 바탕으로, Penguin Solutions는 컴퓨팅 아키텍처, 기술 선택 및 구성을 검증하여 최적화된 AI 팩토리를 위한 신뢰할 수 있는 빌딩 블록을 제공합니다.

이러한 깊이 있는 전문 지식은 원하는 AI 성과를 위해 지속적인 최고 성능을 제공하도록 설계된 풀스택 AI 팩토리 플랫폼을 지원합니다.

끊임없는 변화를 위한 설계

워크로드 변화에 따라 확장 및 적응이 가능한 고정형 구성 대신 분산형 아키텍처를 구현하십시오.

벤더 종속성 방지

가속기, 프로세서, 네트워킹 및 냉각 장치 등 광범위한 멀티 벤더 생태계 전반에서 사전 검증된 시스템을 활용하십시오.

프로덕션으로 가는 길의 위험 요소 제거

25년 이상의 AI 및 HPC 리더십을 통해 검증된 구성으로 통합 병목 현상을 해결하십시오.

ComputeAI의 핵심 구성 요소

ComputeAI는 조직이 경직된 수직 통합형 시스템과 지나치게 복잡한 구성 옵션 사이에서 고민할 필요 없이, 다양한 AI 워크로드 요구 사항에 최적화된 검증된 기술과 구성을 제공합니다.

각 시스템은 효율적인 운영과 안정적인 성능을 위해 설계되었으며, 팀이 AI 팩토리 환경을 위한 탄탄한 컴퓨팅 기반을 구축할 수 있도록 지원합니다.
‍

  • ComputeAI에는 학습, 추론, 스토리지, 로그인, 스케줄러, 패브릭, 관리 등 AI 라이프사이클에 최적화된 사전 정의 및 검증된 노드 역할이 포함되어 있습니다. 이러한 통합 구성을 통해 환경 전반의 인프라 기능을 조정하고 컴퓨팅 계층을 설계 및 검증하는 데 필요한 노력을 줄일 수 있습니다.

  • ComputeAI는 NVIDIA, AMD, Intel을 포함한 주요 가속기 및 프로세서 생태계 전반에서 검증을 거쳤으며, 이를 통해 조직은 멀티 벤더 생태계 내에서 특정 워크로드 요구 사항에 맞는 실리콘 옵션을 자유롭게 선택할 수 있습니다.

  • 고밀도 AI 워크로드는 유연한 열 관리를 필요로 합니다. ComputeAI는 공랭식 및 수랭식 구성을 모두 지원하여 조직이 시설 요구 사항, 성능 목표 및 운영 제약 조건에 맞춰 시스템 설계를 최적화할 수 있도록 합니다.

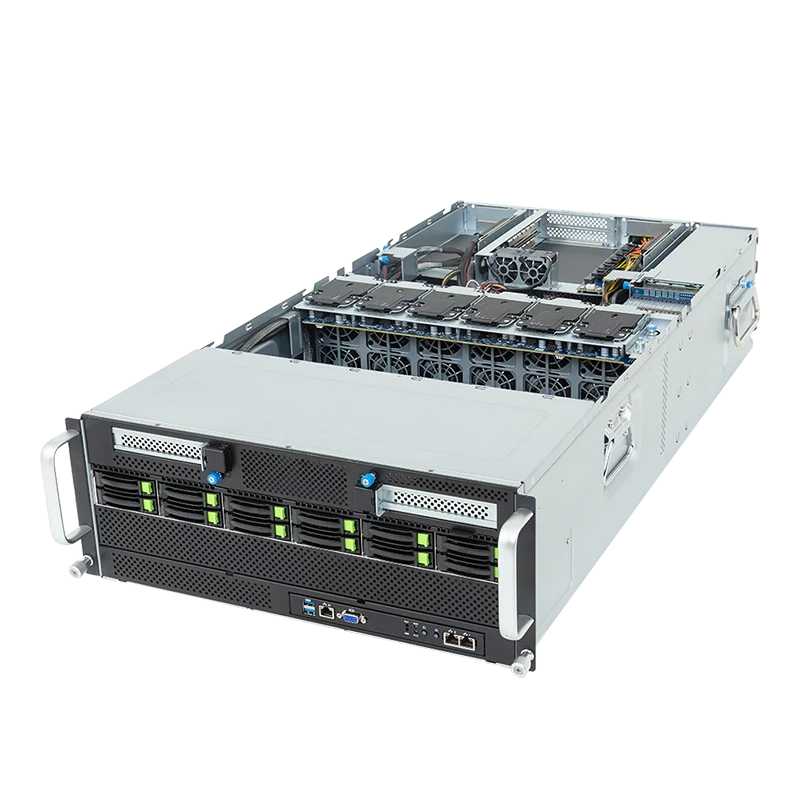
  • ComputeAI 서버

    1U
    프로세서
    PCIe 슬롯
    메모리 용량
    항목을 찾을 수 없습니다.
    2U
    프로세서
    PCIe 슬롯
    메모리 용량
    항목을 찾을 수 없습니다.
    3U
    프로세서
    PCIe 슬롯
    메모리 용량
    항목을 찾을 수 없습니다.
        모델
    GPU
    프로세서
    메모리 용량
  • ComputeAI IEA8-RP6000

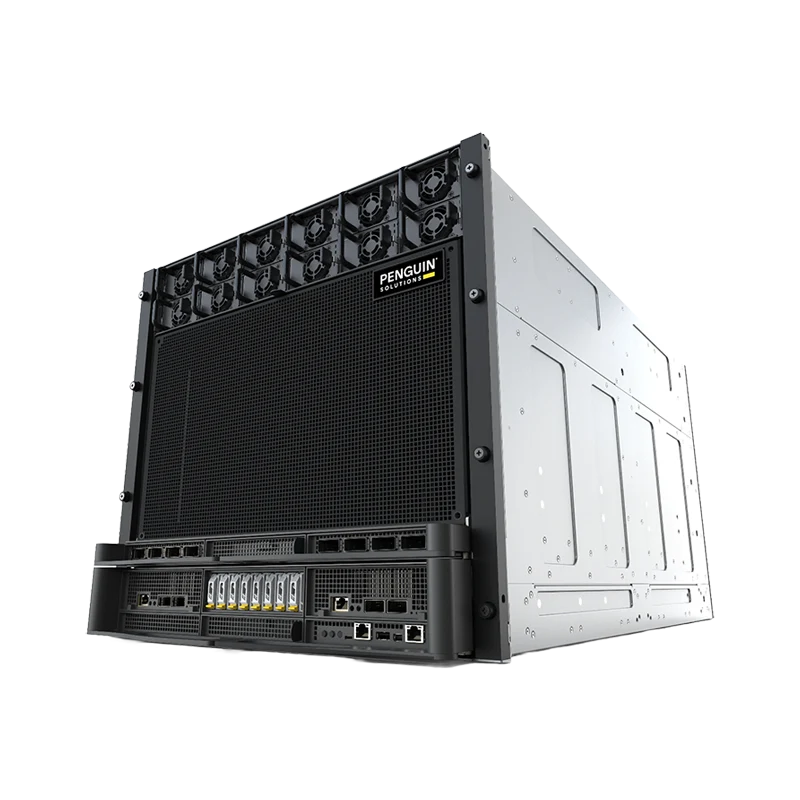
    Penguin Solutions ComputeAI IEA8-RP6000은 AI 추론 및 학습, HPC, 3D 렌더링, 딥러닝, 분석 및 클라우드 네이티브 애플리케이션을 위해 설계된 고도로 구성 가능한 NVIDIA 인증 OVX 플랫폼입니다. 이 시스템은 듀얼 Intel® Xeon® 6 프로세서와 최대 8개의 GPU, 최대 8TB의 DDR5 메모리, 그리고 광범위한 PCIe Gen5 확장 기능을 결합하여 가속 컴퓨팅 워크로드에 필요한 성능과 유연성을 제공합니다.

    GPU:
    NVIDIA H200 NVL, RTX Pro 6000 Blackwell Server Edition
    프로세서:
    Intel® Xeon® 6 Scalable Processors (Granite Rapids-SP)
    메모리 용량:

    8TB DDR5 - 6400 MT/s (1DPC), DDR5 - 5200 MT/s (2DPC); MRDIMM: Up to 8000MT/s

    데이터시트 다운로드
  • ComputeAI AEA8-RP6000

    Penguin Solutions ComputeAI AEA8-RP6000은 기업용 검색 증강 생성(RAG), 지식 어시스턴트, 부서별 코파일럿, 멀티모달 추론 및 모델 적응 워크로드를 위해 설계된 사전 검증된 AI 인프라 플랫폼입니다. 이 시스템은 8개의 NVIDIA RTX PRO 6000 PCIe GPU와 듀얼 AMD EPYC 9575F 프로세서, 768GB의 총 GPU 메모리, 3TB의 DDR5 호스트 메모리, 400GbE 네트워킹을 결합하여 기존 데이터 센터 인프라를 활용하면서 프로덕션 AI 애플리케이션 배포를 가속화합니다.

    GPU:
    8x NVIDIA RTX PRO 6000 PCIe GPUs
    프로세서:
    2x AMD EPYC™ 9575F Processors
    메모리 용량:

    3TB DDR5 - 6400 MT/s

    데이터시트 다운로드
  • ComputeAI AEA8-B300

    Penguin Solutions ComputeAI AEA8-B300은 듀얼 AMD EPYC™ 9005 프로세서와 8개의 NVIDIA HGX™ B300 GPU를 결합하여 AI 추론, 인퍼런스, 학습 및 거대 언어 모델 워크로드에서 탁월한 성능을 제공합니다. 최대 6TB의 DDR5 메모리, NVIDIA ConnectX®-8 SuperNIC 네트워킹, 그리고 NVIDIA NVLink™ 및 NVSwitch™를 통한 1.8TB/s의 GPU 간 대역폭을 갖춘 이 플랫폼은 프로덕션 규모의 생성형 AI 및 멀티 노드 AI 배포를 지원합니다.

    GPU:
    NVIDIA HGX™ B300 with 8 x SXM GPUs
    프로세서:
    AMD EPYC™ 9005/9004 Series
    메모리 용량:

    6TB DDR5 - 6400 MT/s (EPYC 9005), DDR4 - 4800 MT/s (EPYC 9004)

    데이터시트 다운로드
  • ComputeAI IEA8-B300

    Penguin Solutions ComputeAI IEA8-B300은 프로덕션 AI 추론, 고동시성 추론, 대규모 컨텍스트 모델 서빙 및 고급 파인튜닝 워크로드를 위해 설계된 검증된 10U 공랭식 NVIDIA HGX B300 플랫폼입니다. 이 시스템은 듀얼 Intel Xeon 6 프로세서와 8개의 NVIDIA B300 GPU, 2.3TB의 총 GPU 메모리, 4TB의 호스트 DDR5 메모리, 그리고 800Gb/s 스케일 아웃 네트워킹을 결합하여 까다로운 생성형 AI 및 멀티 노드 AI 배포를 지원합니다.

    GPU:
    8x NVIDIA B300 GPUs
    프로세서:
    Intel® Xeon® 6 Scalable Processors (Granite Rapids-SP)
    메모리 용량:

    4TB DDR5 (32 DIMMS)

    데이터시트 다운로드
  • ComputeAI NML72-GB300

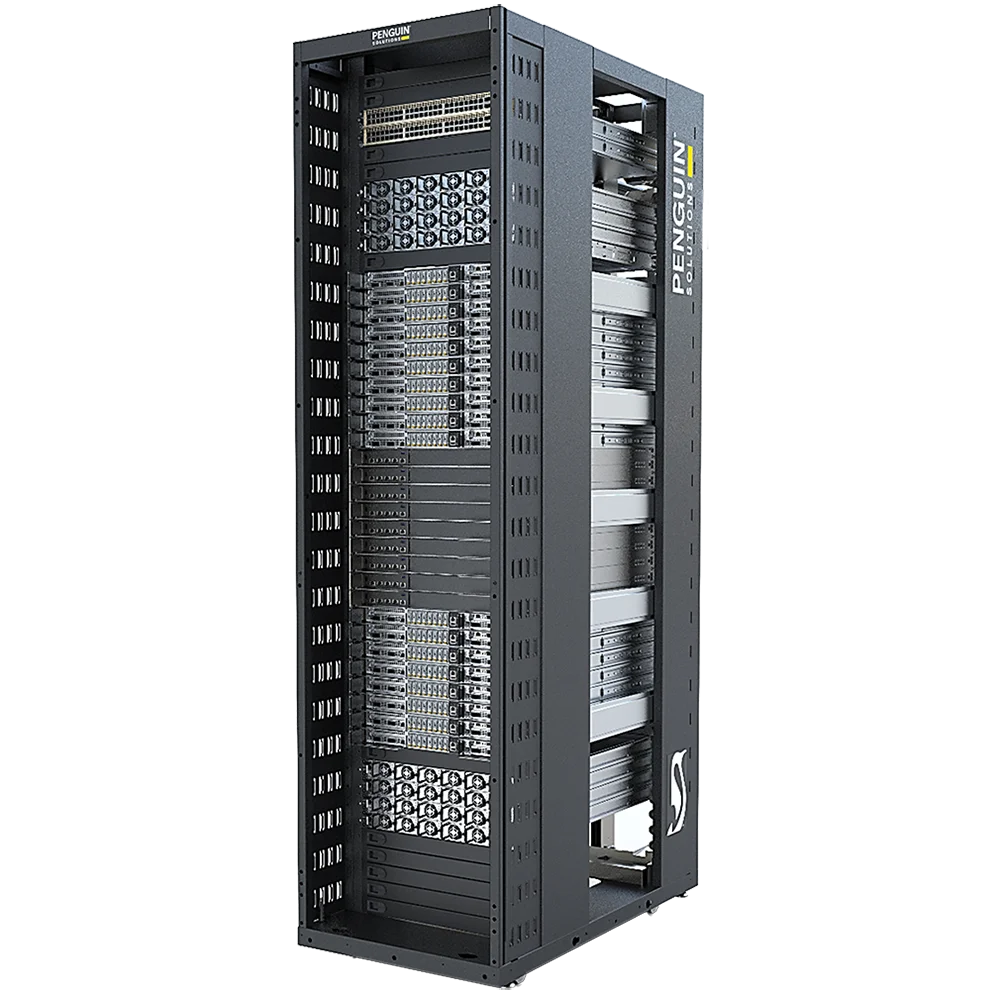
    Penguin Solutions ComputeAI NML72-GB300은 네오클라우드, 소버린 AI, 대규모 모델 학습, AI 추론 및 고처리량 추론 서비스를 위해 설계된 랙 스케일의 직접 액체 냉각 방식 NVIDIA GB300 NVL72 시스템입니다. 검증된 랙 구성은 18개의 컴퓨팅 트레이, 72개의 NVIDIA B300 GPU, 36개의 NVIDIA Grace CPU, 9개의 5세대 NVLink 스위치 트레이를 통합하며, 8-GPU 도메인당 2.3TB급 GPU 메모리를 제공하여 랙당 총 20TB 이상의 GPU 메모리로 확장 가능하고, 단일 L1 도메인을 위한 랙 수준의 NVLink 패브릭을 지원합니다.

    GPU:
    72x NVIDIA B300 GPUs
    프로세서:
    36× NVIDIA Grace CPUs
    메모리 용량:

    17.28TB LPDDR5X

    데이터시트 다운로드
  • ComputeAI AEA1-ADMIN

    Penguin Solutions ComputeAI AEA1-ADMIN은 프로덕션 AI 환경에서 AI 클러스터 운영을 지원하도록 설계된 사전 검증된 관리 및 제어 평면 플랫폼입니다. 인프라 관리 서비스, 모니터링 기능, 인증 서비스, 클러스터 프로비저닝 및 관리자 액세스를 배포 준비가 완료된 아키텍처로 통합함으로써, 이 플랫폼은 조직이 AI 운영을 간소화하고 대규모 인프라를 일관되게 관리할 수 있도록 지원합니다.

    GPU:
    N/A
    프로세서:
    1x AMD EPYC™ 9355P (32 cores)
    메모리 용량:

    384GB DDR5 RDIMM

    데이터시트 다운로드
  • ComputeAI AEA1-K8

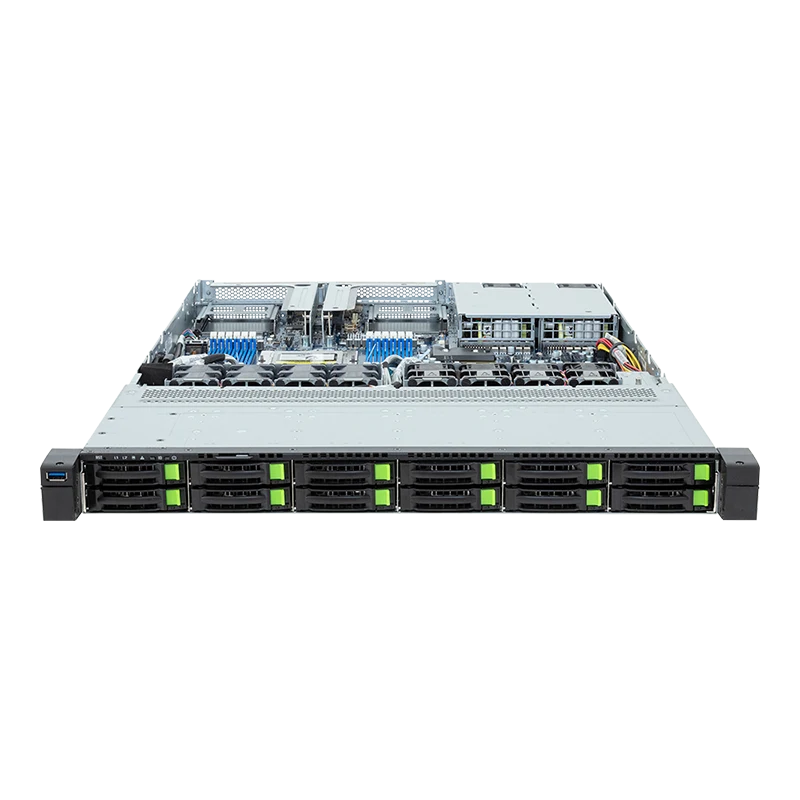
    Penguin Solutions ComputeAI AEA1-K8은 AI 애플리케이션과 프로덕션 AI 환경을 지원하는 CPU 기반 서비스를 호스팅하기 위해 설계된 사전 검증된 Kubernetes 컴퓨팅 인프라입니다. 엔터프라이즈 CPU 컴퓨팅, 고속 네트워킹, 확장 가능한 스토리지, Kubernetes 지원 인프라를 배포 준비가 완료된 아키텍처로 통합한 이 플랫폼은 AI 애플리케이션 호스팅, 엔터프라이즈 RAG 서비스, AI 에이전트, CPU 기반 추론 서비스 및 프로덕션 AI 운영을 지원합니다.

    GPU:
    N/A
    프로세서:
    1x AMD EPYC™ 9555P (64 cores)
    메모리 용량:

    384GB DDR5 RDIMM

    데이터시트 다운로드
  • 5U
    프로세서
    PCIe 슬롯
    메모리 용량
    항목을 찾을 수 없습니다.
    5U
    프로세서
    PCIe 슬롯
    메모리 용량
    항목을 찾을 수 없습니다.
    5U
    프로세서
    PCIe 슬롯
    메모리 용량
    항목을 찾을 수 없습니다.
    콜백 요청

    Penguin Solutions 전문가와 상담하기

    Penguin Solutions 팀에 문의하여 ComputeAI를 통해 통합 복잡성을 줄이고, 설계 위험을 낮추며, AI 인프라 구축을 가속화하는 방법을 알아보세요.

    상담하기