製品 > ComputeAI™

AI導入を加速し、予測可能性を高める高度なコンピューティングシステム

統合の複雑さを軽減し、AIインフラストラクチャ設計のリスクを最小限に抑え、各AI成果に最適なテクノロジーを選択する柔軟性を維持します。

お問い合わせ
価格を問い合わせる
アドバンスド・コンピューティング・ポートフォリオ

価値実現までの時間を短縮し、予測可能なパフォーマンスを確立する事前検証済みコンピューティング

AIファクトリーの導入と管理には、多額の資本投資と運用上の精度が求められます。従来の導入手法では、コンピューティングの統合に関する課題やベンダー側の設計制限により、プロジェクトが停滞することが少なくありません。インフラの構築が遅れたり、十分に活用されなかったりすると、投資収益率(ROI)は低下してしまいます。

Penguin SolutionsのComputeAI™ポートフォリオは、こうした複雑さとリスクを軽減します。一貫したパフォーマンスをサポートするように設計された、本番環境対応の事前検証済みアドバンスド・コンピューティング・システムにより、組織はハードウェアの統合に費やす時間を削減し、AIイニシアチブの推進とビジネス価値の創出により多くの時間を割くことができます。

25年以上にわたるAIおよびHPCの経験を活かし、Penguin Solutionsはコンピューティング・アーキテクチャ、技術選定、構成を検証することで、最適化されたAIファクトリーのための信頼性の高いビルディングブロックを提供します。

この深い専門知識により、AIの成果を最大化するために持続的かつ最高レベルのパフォーマンスを発揮するよう設計された、フルスタックのAIファクトリー・プラットフォームを支えています。

絶え間ない変化に対応するアーキテクチャ

ワークロードの進化に合わせて拡張・適応できる、固定構成ではないディスアグリゲーテッド(分離型)アーキテクチャを実現します。

ベンダーロックインの回避

アクセラレータ、プロセッサ、ネットワーキング、冷却技術など、幅広いマルチベンダーエコシステム全体で事前検証済みのシステムを活用します。

本番環境への移行リスクを低減

25年以上にわたるAIおよびHPC分野でのリーダーシップに基づき検証された構成により、統合のボトルネックを解消します。

ComputeAIの主要コンポーネント

ComputeAIは、組織が硬直的で垂直統合されたシステムか、あるいは膨大な構成の選択肢かという二者択一を迫られるのではなく、多様なAIワークロードの要件に合わせた検証済みのテクノロジーと構成を提供します。

各システムは効率的な運用と信頼性の高いパフォーマンスを実現するように設計されており、AIファクトリー環境の強固なコンピューティング基盤を構築できます。
‍

  • ComputeAIには、AIライフサイクル向けに最適化された、事前定義および事前検証済みのノードロールが含まれています。これには、トレーニング、推論、ストレージ、ログイン、スケジューラ、ファブリック、管理などが含まれます。これらの統合された構成により、環境全体でインフラストラクチャ機能を調整し、コンピューティング層の設計と検証にかかる工数を削減できます。

  • ComputeAIは、NVIDIA、AMD、Intelを含む主要なアクセラレータおよびプロセッサのエコシステム全体で検証済みです。これにより、組織はマルチベンダー環境において、特定のワークロード要件に最適なシリコンを柔軟に選択できます。

  • 高密度なAIワークロードには、適応性の高い熱管理が不可欠です。ComputeAIは空冷および液冷の両方の構成をサポートしており、組織は施設要件、パフォーマンス目標、運用上の制約に合わせてシステム設計を最適化できます。

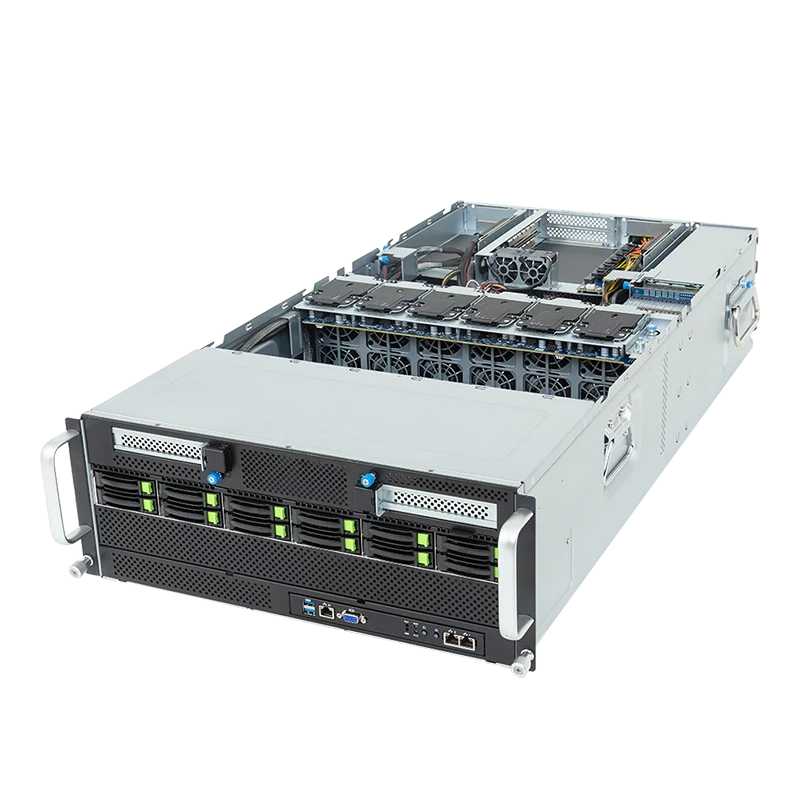
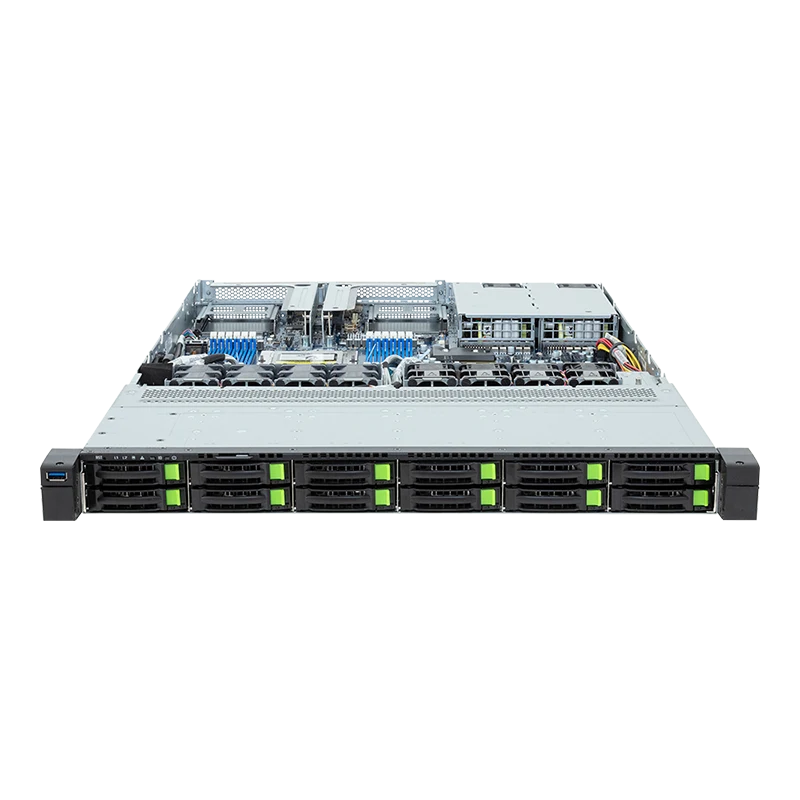
  • ComputeAIサーバー

    1U
    プロセッサー
    PCIe スロット
    メモリ容量
    アイテムが見つかりません。
    2U
    プロセッサー
    PCIe スロット
    メモリ容量
    アイテムが見つかりません。
    3U
    プロセッサー
    PCIe スロット
    メモリ容量
    アイテムが見つかりません。
        モデル
    GPU
    プロセッサ
    メモリ容量
  • ComputeAI IEA8-RP6000

    Penguin Solutions ComputeAI IEA8-RP6000は、AI推論や学習、HPC、3Dレンダリング、ディープラーニング、アナリティクス、クラウドネイティブアプリケーション向けに設計された、構成の柔軟性が高いNVIDIA認定OVXプラットフォームです。本システムは、2基のIntel® Xeon® 6プロセッサを搭載し、最大8基のGPU、最大8 TBのDDR5メモリ、そして広範なPCIe Gen5拡張をサポートすることで、アクセラレーテッドコンピューティングのワークロードに求められるパフォーマンスと柔軟性を実現します。

    GPU:
    NVIDIA H200 NVL, RTX Pro 6000 Blackwell Server Edition
    プロセッサ:
    Intel® Xeon® 6 Scalable Processors (Granite Rapids-SP)
    メモリ容量:

    8TB DDR5 - 6400 MT/s (1DPC), DDR5 - 5200 MT/s (2DPC); MRDIMM: Up to 8000MT/s

    データシートをダウンロード
  • ComputeAI AEA8-RP6000

    Penguin Solutions ComputeAI AEA8-RP6000は、エンタープライズ向けの検索拡張生成(RAG)、ナレッジアシスタント、部門別コパイロット、マルチモーダル推論、およびモデル適応ワークロード向けに設計された、事前検証済みのAIインフラストラクチャプラットフォームです。本システムは、8基のNVIDIA RTX PRO 6000 PCIe GPUとデュアルAMD EPYC 9575Fプロセッサを組み合わせ、合計768 GBのGPUメモリ、3 TBのDDR5ホストメモリ、および400 GbEネットワーキングを備えており、既存のデータセンターインフラストラクチャを活用しながら、本番環境でのAIアプリケーション導入を加速させます。

    GPU:
    8x NVIDIA RTX PRO 6000 PCIe GPUs
    プロセッサ:
    2x AMD EPYC™ 9575F Processors
    メモリ容量:

    3TB DDR5 - 6400 MT/s

    データシートをダウンロード
  • ComputeAI AEA8-B300

    Penguin Solutions ComputeAI AEA8-B300は、2基のAMD EPYC™ 9005プロセッサと8基のNVIDIA HGX™ B300 GPUを組み合わせ、AIの推論、学習、および大規模言語モデルのワークロードにおいて卓越したパフォーマンスを発揮します。最大6TBのDDR5メモリ、NVIDIA ConnectX®-8 SuperNICネットワーキング、そしてNVIDIA NVLink™およびNVSwitch™による1.8TB/sのGPU間帯域幅を備えたこのプラットフォームは、プロダクションスケールの生成AIやマルチノードAIのデプロイメントを強力にサポートします。

    GPU:
    NVIDIA HGX™ B300 with 8 x SXM GPUs
    プロセッサ:
    AMD EPYC™ 9005/9004 Series
    メモリ容量:

    6TB DDR5 - 6400 MT/s (EPYC 9005), DDR4 - 4800 MT/s (EPYC 9004)

    データシートをダウンロード
  • ComputeAI IEA8-B300

    Penguin SolutionsのComputeAI IEA8-B300は、AI推論のプロダクション環境、高並列推論、大規模コンテキストモデルのサービング、および高度なファインチューニングワークロード向けに設計された、検証済みの10U空冷式NVIDIA HGX B300プラットフォームです。本システムは、2基のIntel Xeon 6プロセッサと8基のNVIDIA B300 GPUを搭載し、合計2.3 TBのGPUメモリ、4 TBのホストDDR5メモリ、および800 Gb/sのスケールアウト・ネットワーキングを組み合わせることで、負荷の高い生成AIやマルチノードAIのデプロイメントを強力にサポートします。

    GPU:
    8x NVIDIA B300 GPUs
    プロセッサ:
    Intel® Xeon® 6 Scalable Processors (Granite Rapids-SP)
    メモリ容量:

    4TB DDR5 (32 DIMMS)

    データシートをダウンロード
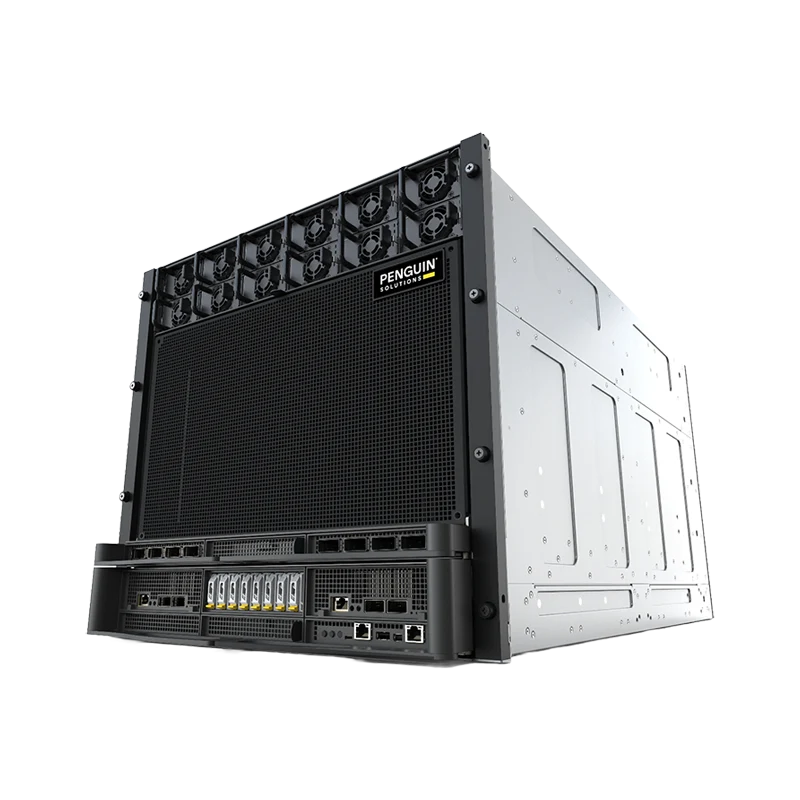
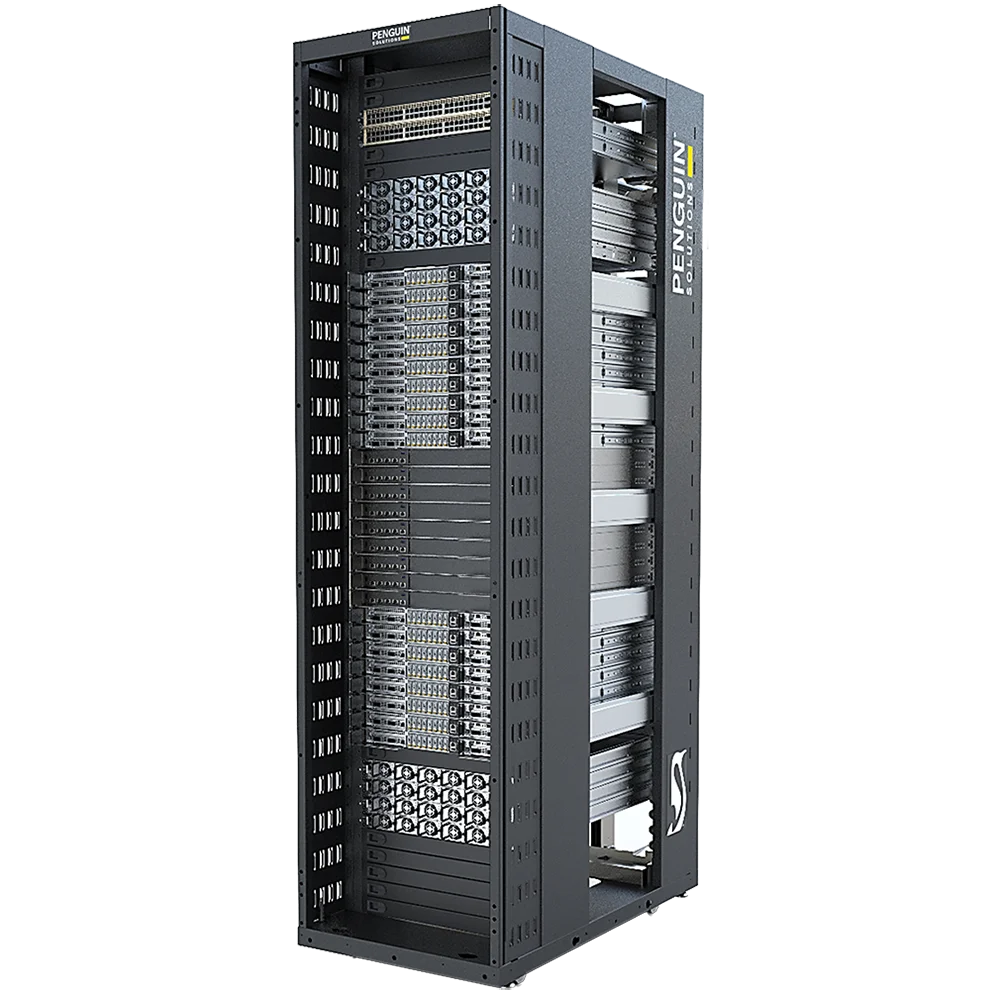
  • ComputeAI NML72-GB300

    Penguin SolutionsのComputeAI NML72-GB300は、ネオクラウド、ソブリンAI、大規模モデルのトレーニング、AI推論、および高スループットな推論サービス向けに設計された、ラックスケールの直接液冷式NVIDIA GB300 NVL72システムです。この検証済みラック構成には、18個のコンピュートトレイ(72個のNVIDIA B300 GPUと36個のNVIDIA Grace CPUを搭載)、9個の第5世代NVLinkスイッチトレイが統合されています。また、8 GPUドメインあたり2.3 TBクラスのGPUメモリを備え、ラック全体で20 TBを超えるGPUメモリに拡張可能なほか、単一のL1ドメインを実現するラックレベルのNVLinkファブリックを提供します。

    GPU:
    72x NVIDIA B300 GPUs
    プロセッサ:
    36× NVIDIA Grace CPUs
    メモリ容量:

    17.28TB LPDDR5X

    データシートをダウンロード
  • ComputeAI AEA1-ADMIN

    Penguin Solutions ComputeAI AEA1-ADMINは、本番AI環境におけるAIクラスター運用をサポートするために設計された、事前検証済みの管理・制御プレーンプラットフォームです。インフラストラクチャ管理サービス、監視機能、認証サービス、クラスタープロビジョニング、および管理アクセスを導入可能なアーキテクチャに統合することで、組織によるAI運用の簡素化と、大規模なインフラストラクチャ管理の一貫性維持を支援します。

    GPU:
    N/A
    プロセッサ:
    1x AMD EPYC™ 9355P (32 cores)
    メモリ容量:

    384GB DDR5 RDIMM

    データシートをダウンロード
  • ComputeAI AEA1-K8

    Penguin Solutions ComputeAI AEA1-K8は、AIアプリケーションや、本番環境のAI運用を支えるCPUベースのサービスをホストするために設計された、事前検証済みのKubernetesコンピュートインフラストラクチャです。エンタープライズ向けのCPUコンピュート、高速ネットワーキング、スケーラブルなストレージ、そしてKubernetes対応のインフラストラクチャを導入可能なアーキテクチャに統合することで、AIアプリケーションのホスティング、エンタープライズRAGサービス、AIエージェント、CPUベースの推論サービス、および本番環境でのAI運用を強力にサポートします。

    GPU:
    N/A
    プロセッサ:
    1x AMD EPYC™ 9555P (64 cores)
    メモリ容量:

    384GB DDR5 RDIMM

    データシートをダウンロード
  • 5U
    プロセッサー
    PCIe スロット
    メモリ容量
    アイテムが見つかりません。
    5U
    プロセッサー
    PCIe スロット
    メモリ容量
    アイテムが見つかりません。
    5U
    プロセッサー
    PCIe スロット
    メモリ容量
    アイテムが見つかりません。
    コールバックをリクエストする

    Penguin Solutionsの専門家に相談する

    Penguin Solutionsチームに問い合わせて、ComputeAIを活用したAIインフラストラクチャの統合の複雑さの軽減、設計リスクの低減、および導入の加速についてご確認ください。

    相談する