AI 和 HPC 数据中心
容错解决方案
集成内存
AI 云服务提供商需要能够无缝构建、扩展并运行 GPU 即服务 (GPUaaS) AI 工厂,以实现峰值性能,从而在满足客户对 AI 计算日益增长的需求的同时,加快创收速度。
推理和代理 AI 的需求增长速度已超过了 GPU、电力、冷却和网络容量的承载能力,这使得快速部署、经过验证的架构以及可靠的生产执行变得至关重要。
AI 工作负载需要在高密度、多租户环境中保持一致的吞吐量和低延迟网络性能,这对满足客户 SLA 并避免工作流中断至关重要。
部署差异化的 GPUaaS 能力,需要将基础设施、部署专业知识和运营执行力在整个 AI 工厂堆栈中进行整合,并需要一个值得信赖的合作伙伴来实现这一目标。
Penguin Solutions 是领先的内存和 AI 基础设施提供商,致力于交付全栈 AI 工厂平台。凭借数十年的深厚经验,我们助力 AI 云服务提供商加速工作负载、实现高效扩展,并最大化其 AI 投资价值。
AI 云服务提供商需要快速上线 GPU 容量,以满足需求并尽早获取收益。Penguin Solutions OriginAI® 基础设施解决方案 提供经过验证的架构、高效的设计支持以及久经考验的部署与管理专业知识,助力加速实现价值。这意味着客户可以减少解决基础设施问题的时间,将更多精力投入到为用户提供 GPUaaS 容量上。
AI 工作负载依赖于高吞吐量、低延迟的网络基础设施,以确保 GPU 得到充分利用。Penguin Solutions 对从计算、先进内存、网络到整体集群设计与管理的全栈进行优化。我们的 OriginAI 解决方案集成了 ComputeAI™ 系统、ClusterWareAI™ AI 工厂操作系统软件 以及 端到端生命周期服务,并提供内存服务器选项(如 MemoryAI™ KV 缓存服务器),以确保大规模环境下的持续、安全性能。
构建大规模 AI 基础设施不仅成本高昂,而且管理复杂。Penguin Solutions 通过涵盖专家规划、经过验证的设计以及托管服务的端到端服务,降低部署风险,帮助 AI 云服务提供商避免代价高昂的延误和返工。这让 GPU 云服务提供商能够充满信心地扩展容量,满足客户动态的 AI 需求,同时加速实现收益。
“有了像 Penguin 这样为我们的项目增加交付能力的合作伙伴,我们预计能够更快地进行部署并承担更多的构建任务,我们的客户也能够在 Axe Compute 所定义的灵活、可靠且端到端的运营模式下,激活并维持高性能 AI 基础设施。”
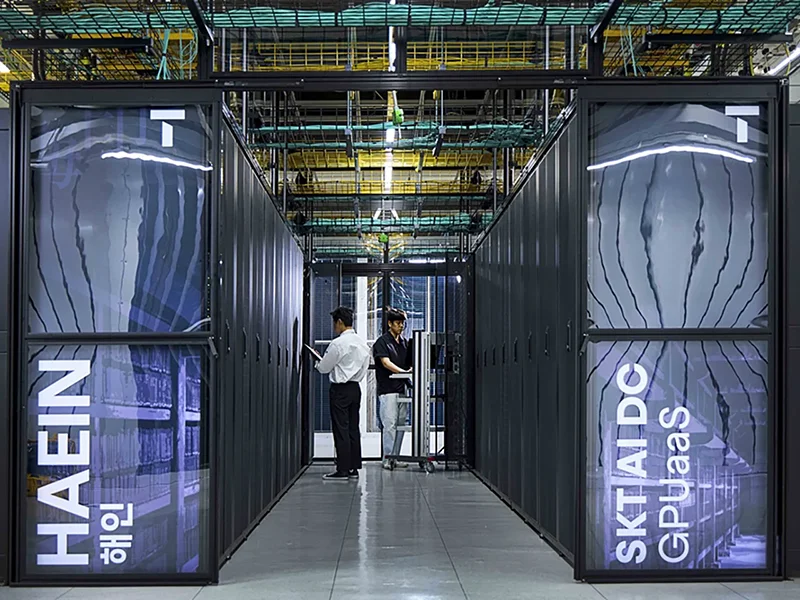
Penguin Solutions与SK Telecom合作,为“Haein”提供支持,这是韩国最大的主权AI集群之一,旨在提供GPUaaS以支持大规模训练和推理工作负载。该集群基于经过验证的基础设施构建并精确部署,在材料运抵现场后仅数周内便投入生产。
阅读完整故事,了解如何与Penguin Solutions合作,实现快速行动、自信扩展,并以生产级质量支持严苛的AI工作负载。


OriginAI® 是一种AI工厂基础设施解决方案,它基于成熟的、预定义的AI架构构建,可扩展至数百个乃至超过16,000个GPU集群。OriginAI将这些经过验证的技术与Penguin智能、直观的集群管理软件和专业服务相结合。

简化 AI 集群的部署和管理,以快速实现高生产力。裸机硬件、网络和软件资源被转化为高性能集群环境,从而简化管理复杂性并优化资源可用性。

Penguin Solutions 设计并部署了大型 NVIDIA DGX 集群,配备高速 NVIDIA InfiniBand 网络和优化的存储。我们与大多数存储供应商建立了合作关系并拥有专业知识,使我们能够为每位客户提供定制化解决方案。
Penguin Solutions 负责打理 AI 工厂,让 AI 云服务提供商能够专注于其 GPUaaS 的差异化优势。立即联系我们,了解 Penguin Solutions 如何助力您扩展 AI 环境,以应对训练、推理和智能体工作负载的需求。