
本地 AI 工厂,开箱即用
在本地构建和扩展 AI 需要具备高性能、高效率和可扩展性的基础设施。Penguin Solutions 提供全面的 GPU 服务器和加速计算平台产品组合,为模型训练、推理和数据密集型工作负载提供动力。
随着 AI 模型在规模和计算复杂度上的不断增长,企业必须在计算性能、内存容量、运营效率与扩展需求之间取得平衡。Penguin Solutions 凭借其全栈 AI 基础设施产品组合,助力客户应对这一挑战,设计出可自信部署的生产就绪型环境。
每项 AI 计划的起点各不相同,具体取决于所涉及的工作负载、数据和增长规划。Penguin Solutions 提供一系列先进的计算平台,以满足贵组织的特定需求并加速创新。
从 GPU 密集型计算到大内存系统,再到集成式企业架构,每个平台都经过精心设计,确保从第一天起即可投入运行,并能随着需求的变化进行扩展。Penguin 的整个产品组合不仅提供原始算力,更致力于实现真正的业务成果。

ComputeAI™
AI 工厂的部署往往因计算集成挑战和供应商设计限制而陷入停滞,而基础设施的延迟或利用率不足则会削弱投资回报率 (ROI)。
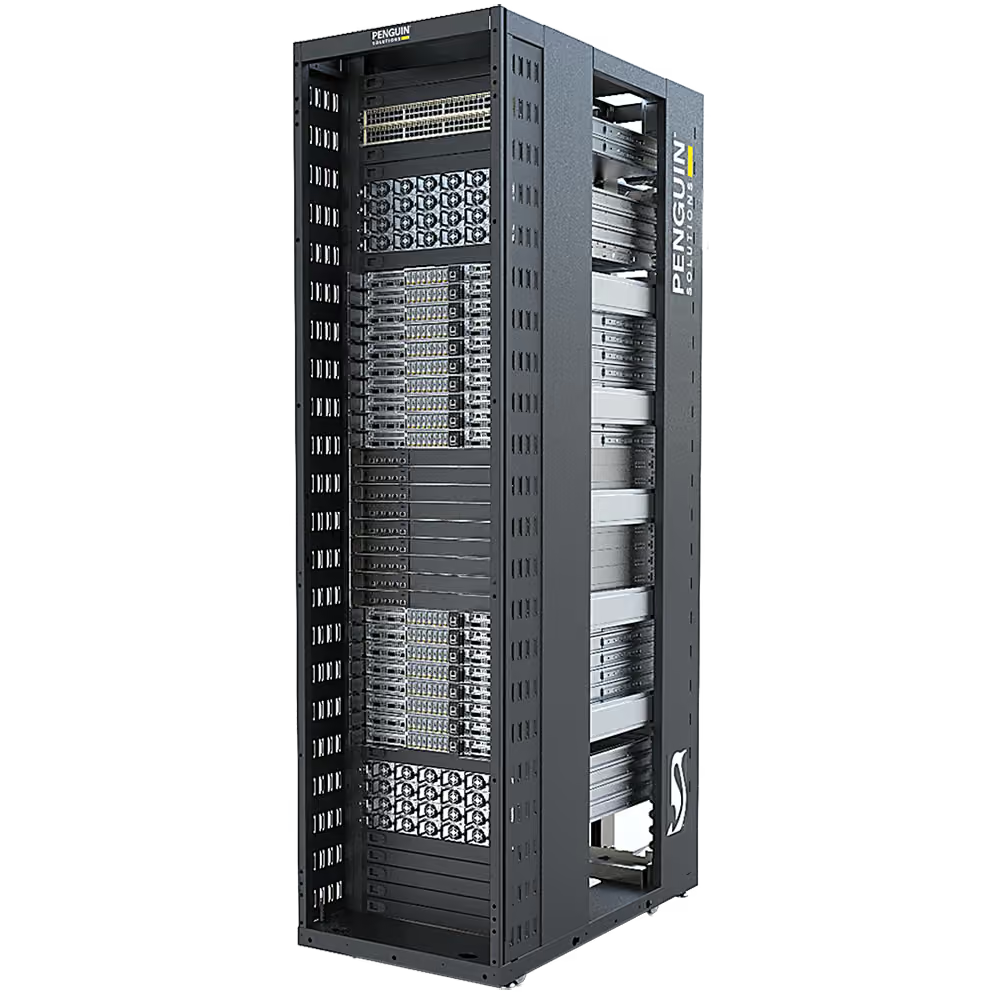
ComputeAI™ 产品组合降低了集成复杂性和设计风险。这些经过预验证、可直接投入生产的计算系统从一开始就能确保性能的可预测性。每一套系统均在 NVIDIA、AMD 和 Intel 生态系统中经过验证,并依托于超过 25 年的 AI 和 High-Performance Computing 经验。
结合 Penguin Solutions 在集群架构和 AI 工厂部署方面的专业知识,ComputeAI 服务器为高性能 AI 环境奠定了灵活的基础,让团队能够减少在硬件集成上花费的时间,从而专注于创造业务价值。
MemoryAI™
随着大语言模型 (LLM) 和 AI 推理工作负载将内存需求推向传统系统的极限,Penguin Solutions 推出的 CXL 内存扩展服务器能够帮助企业突破内存瓶颈。
Penguin Solutions 正在申请专利的 MemoryAI™ KV Cache Server 是业界首款可投入生产的键值 (KV) 缓存服务器。这一大内存解决方案利用 CXL 内存提供高容量内存设备,专为打破内存墙而设计,旨在支持大规模高性能 AI 推理。
凭借数十年的先进内存专业经验,Penguin Solutions 的 MemoryAI KV Cache Server 不仅扩展了内存容量,还提高了资源利用率,使 AI 环境能够在不增加基础设施复杂性的前提下,支持更大的模型、更长的上下文窗口以及要求更高的工作负载。

NVIDIA DGX™ 系统
从基础模型训练到大规模 AI 推理与逻辑运算,NVIDIA DGX 系统凭借 NVIDIA Blackwell™ 架构的卓越性能,能够胜任最严苛的 AI 工作负载。
作为 NVIDIA AI Factory 专业合作伙伴及经验丰富的 DGX-Ready 托管服务提供商,Penguin Solutions 能够通过经过验证的架构、高性能网络、存储集成以及全生命周期服务,助力客户大规模部署并运营 DGX 环境。
通过将 NVIDIA DGX 技术与 Penguin Solutions 的 AI 工厂专业知识相结合,企业能够缩短价值实现时间 (TTV),并确保关键任务 AI 工作负载的性能表现稳定可期。

Dell AI 基础设施
Dell AI 基础设施将计算、存储、网络和软件集成到统一的企业级架构中,从而支持大规模的 AI 开发和生产工作负载。
作为 2026 年度 Dell Technologies 美洲区 AI 合作伙伴,Penguin Solutions 将其在 AI 基础设施方面的专业知识与 Dell Technologies 的企业级平台相结合,提供专为可扩展性、可靠性和运营效率而设计的验证型 AI 工厂解决方案。
通过利用成熟的设计和丰富的部署经验,Penguin Solutions 能够帮助企业加速实施进程、简化管理流程,并降低与大规模 AI 基础设施项目相关的风险。


与 Penguin Solutions 的专家交流
Penguin Solutions 汇集了服务器、平台、服务和专业知识,旨在提供大规模的全栈 AI 基础设施。我们的 AI 服务器和集成计算平台产品组合支持从大规模模型训练和推理到内存密集型工作负载的各种应用。