
ClusterWareAI™
AI工厂平台操作系统软件
无论是十个节点还是数万个节点,ClusterWareAI 软件都能统一计算和软件资源,实现自动化部署、优化性能,并为 IT 团队简化复杂的集群操作。
面向企业推理和模型调优的 AI 工厂基础设施管理
ClusterWareAI 操作系统软件增强了您的团队部署、管理和优化人工智能 (AI) 工厂基础设施的能力,以实现持续的峰值性能、可用性和可靠性,从而自信地满足服务水平承诺。
无论是满足训练还是推理的工作负载需求,云服务提供商、企业以及支持 AI 计划的组织都必须保持专业且严苛的训练与推理集群所需的性能、可用性和可靠性。
ClusterWareAI AI Factory Platform 操作系统软件基于 Penguin Solutions 数十年的 AI 和 HPC 运营专业知识,并结合了超过 40 亿小时的 GPU 运行经验,提供了一个与硬件无关的集群控制平面,可将计算、内存、网络、存储和软件资源转化为统一的全栈 AI 工厂。它在单一、内聚且具备自愈能力的系统中,为数千个节点、多个网络和各种调度程序提供端到端的可见性和智能管理。
这款 AI 工厂操作系统软件可扩展至各种 AI 平台架构,包括 x86 环境、基于 Arm 的系统(如 NVIDIA Vera Rubin 平台)以及支持 DPU 的基础设施(包括 NVIDIA BlueField DPU)。ClusterWareAI 能够帮助基础设施团队更快地实现容量上线,保持可靠服务交付所需的峰值性能和可用性,并在环境扩展时最大化 AI 基础设施的投资回报。

管理并优化用于训练和推理的 AI 工厂
ClusterWareAI 软件通过智能自动化、行业领先的遥测技术以及开放的硬件和软件生态系统,简化了 AI 基础设施的部署、管理、监控和扩展,是管理训练和推理集群的理想选择。

统一并抽象化 AI 工厂内的专用硬件和软件资源,为硬件、网络和软件提供一个与供应商无关的控制平面,同时在 AI 平台架构间扩展一致的管理基础,并提供深度的硬件级遥测、直观的 GUI 以及来自我们 AI Factory Operations Agent 的洞察。
通过对计算、网络和 GPU/CPU 健康状况的实时监控,结合主动异常检测、硬件感知修复、规范性维修指导以及与既有 IT 警报工作流的集成,为训练和生产推理提供峰值性能与可靠性。
通过零接触配置 (Zero-Touch Provisioning)、智能编排以及我们 AI Factory Operations Agent 提供的对话式诊断,加速 AI 基础设施的部署并降低运营复杂性,帮助团队更快地进行部署、高效排查问题并保持峰值性能。
通过高可用性、与硬件无关的配置以及在成熟调度器上的大规模训练和通过 Kubernetes 进行的生产推理,实现跨数千个节点的智能工作负载分配与编排。
依托 Penguin Solutions 数十年的 AI 和 HPC 运营经验,确保基础设施的长期可靠性和最大化 ROI。
面向 AI 工厂的企业级集群运维
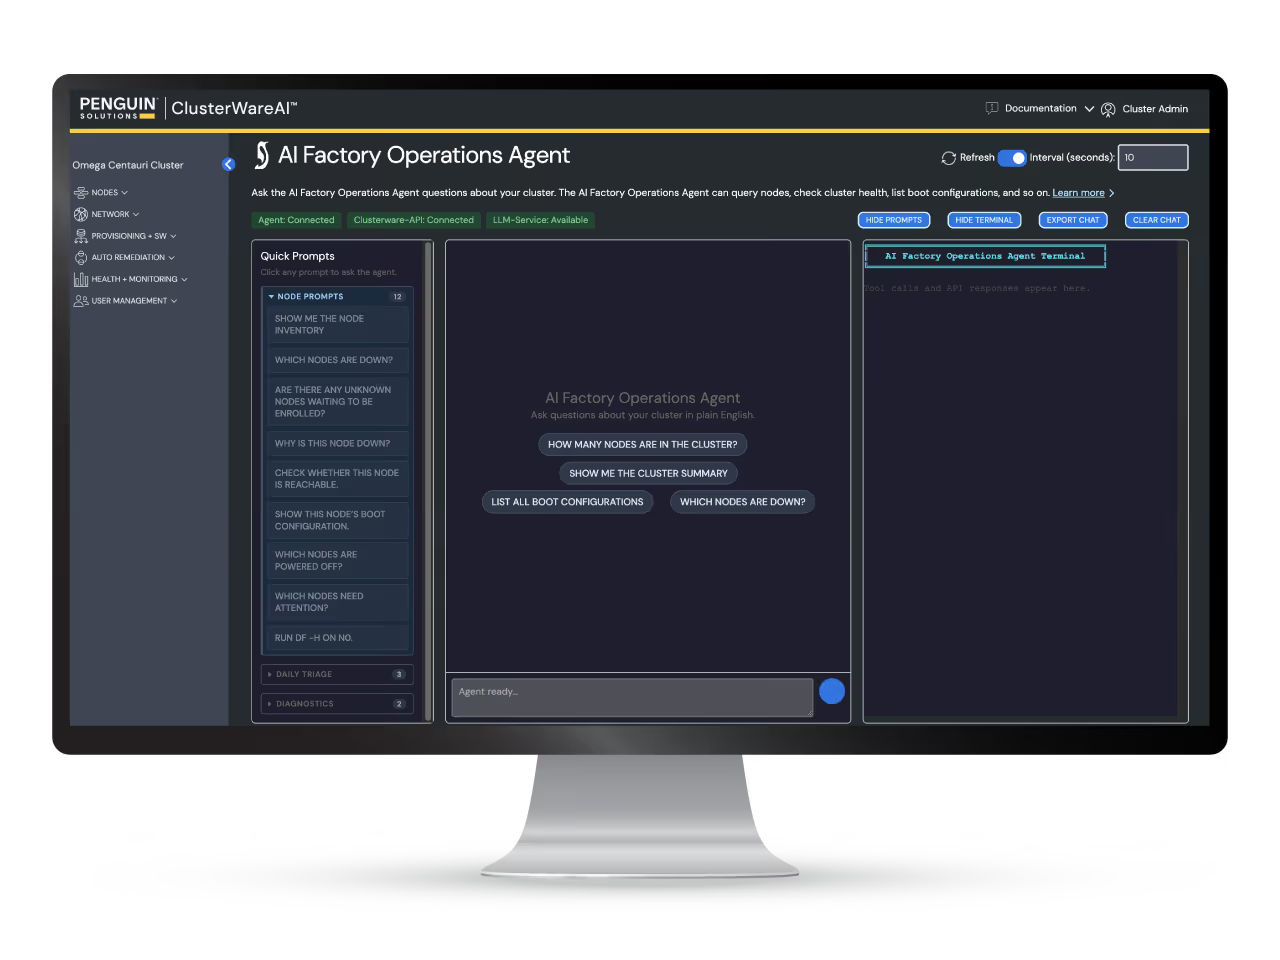
AI 工厂运维助手
AI 工厂运维助手是内置于 ICE ClusterWare 软件中的一系列 AI 助手中的首款产品,旨在增强基础设施团队和集群管理员的集群运维能力与洞察力。通过 AI 自然语言界面,运维人员只需进行简单的对话,即可收集集群洞察、获取运维背景信息并调取相关的基础设施数据。
通过将诊断过程简化为直观的对话,AI 工厂运维助手能够调查问题、分析基础设施健康状况并加速根本原因分析,使整个运维团队都能获得深入的系统洞察。这降低了对少数资深专家的依赖,帮助团队更快地调查问题,并将精力集中在更高价值的工作上。
先进性能优化
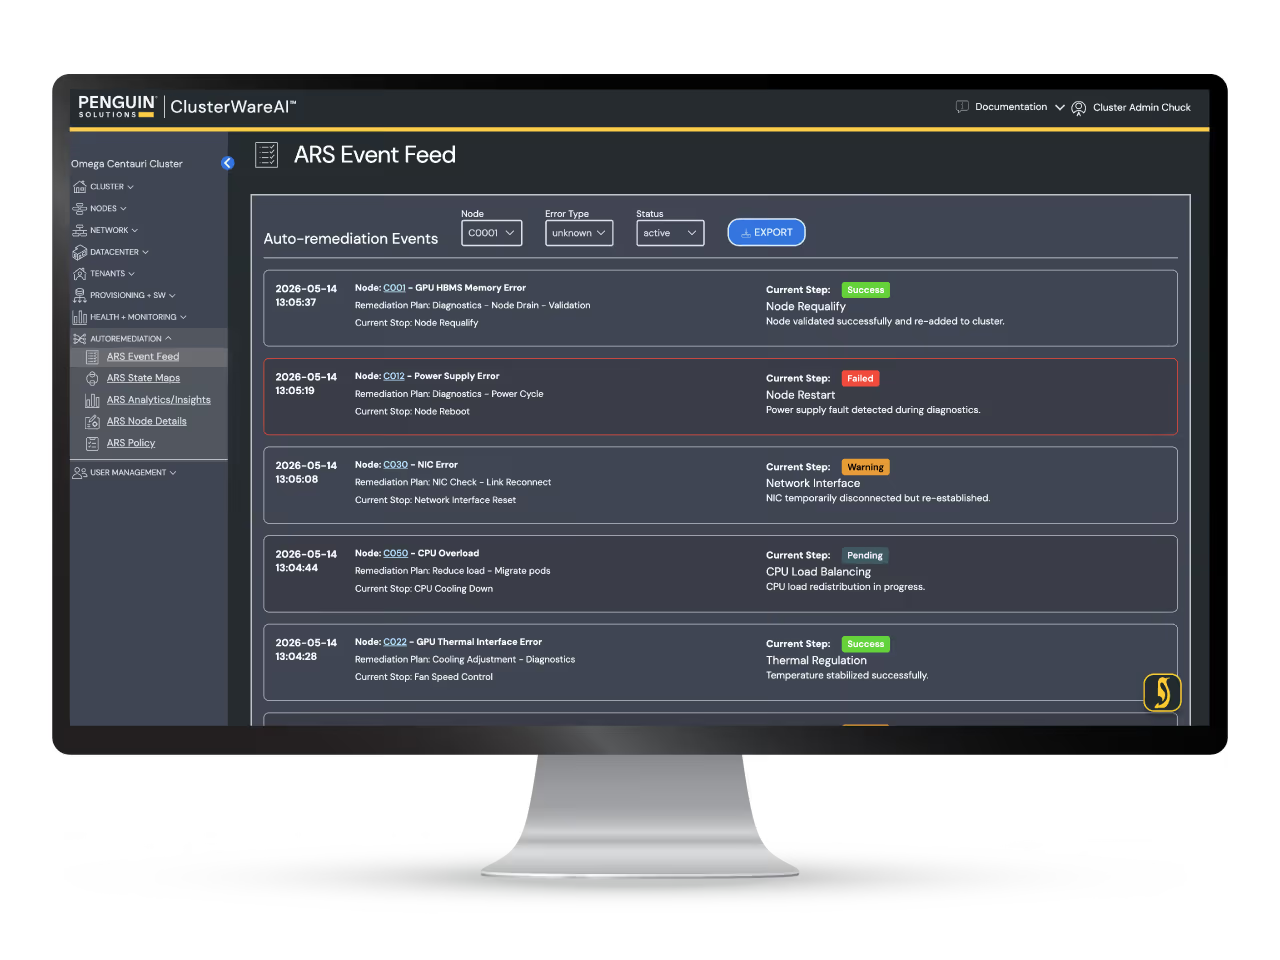
ClusterWareAI 软件可在大型 AI 环境中提供卓越的性能、弹性和资源可用性,同时降低运维复杂度。通过将智能自动化与深度的硬件级可视化相结合,它能够持续监控基础设施,在问题影响工作负载之前将其检测出来,并启动自我修复以维持集群性能。
对于生产推理环境,ClusterWareAI 结合了针对 Kubernetes 工作负载的自动修复功能、用于深入了解基础设施的本地健康监控,以及通过 AI Factory Operations Agent 实现的对话式诊断。ClusterWareAI 还通过数据驱动的规范性修复建议,加快了人工参与决策的流程。这些功能相辅相成,帮助团队更快地识别并解决问题,同时保持 AI 基础设施的可靠性和高性能。

咨询 Penguin Solutions 专家
与我们的专家联系,了解 ClusterWareAI AI 工厂平台操作系统软件如何支持您的 AI 工厂平台——无论您是刚刚起步,还是希望优化现有的 AI 数据基础设施。